Pokazywanie postów oznaczonych etykietą certyfikaty. Pokaż wszystkie posty

niedziela, 26 sierpnia 2012

Clariion - zarządzanie SP,Modułami I/O i Portami

Kolejny wpis z serii przygotowujących do egzaminu na Clariion specjalistę. Poprzednio opisywałem zarządzanie dyskami, teraz skupimy się na pozostałych komponentach.


Zarządzanie Service Procesorem:

Jeżeli przejdziemy do menu System-->Hardware na danej macierzy po lewej stronie ekranu będziemy widzieli panel z grupą opcji związanych z zarządzaniem SP A i SP B:


Mamy tutaj kilka opcji związanych z zarządzaniem Service Procesorami. Z tego poziomu możemy przeładować kontroler, zebrać pliki Diagnostyczne (tzw: SPCollects), a także przeprowadzić kongfigurację właściwości sieciowych danego SP i zrobić bardzo podstawowy troubleshooting problemów związanych z siecią, za pomocą narzędzi ping i traceroute.

Po wybraniu opcji Properties otworzy się okno zawierajace osiem zakładek:


W zakłace General mamy podstawowe informacje o stanie kontrolera, firmware, nr seryjnym itd...
Pozostałe także zawierają pewne ogólne dane i statystyki - nic co wymagało by większego tłumaczenia. Jedynym miejscem gdzie warto zajrzeć jest zakładka Network


Możemy w tym okienku ustawić kilka spraw związanych z siecią:
  • Management Port Settings - opcje związane z działaniem portu zarządzania SP
    • Requested settings - z jaką prędkością i w jakim trybie chcemy żeby pracował (domyślnie: Auto)
    • Link Status - a w jakim naprawdę pracuje
  • SNMP Settings - ustawienia SNMP
    • Enable/Disable processing of SNMP MIB read requests - włączenie wyłączenie obsługi SNMP dla tego kontrolera
    • SNMP Community - tutaj można ustawić tzw: " SNMP Community String" czyli pewien rodzaj klucza, którym autentyfikować się muszą urządzenia, wymieniające się danymi poprzez SNMP.
  • Virtual Port Properties - IP adres oraz tzw: VLAN ID naszego kontrolera. 
Po wybraniu przycisku "Properties" możemy przejść do kolejnego okienka z ustawieniami dotyczącymi sieci:


Tutaj dokonujemy wyboru podstawowych ustawień sieci: IP,Maska,Brama, dodatkowo możemy skonfigurować konroler do pracy w sieci IPv6. Te wielkości które tutaj ustawimy będą adresem sieciowym naszego SP (a tak bardziej szczegółowo portu sieciowego, do którego się będziemy podłączali, gdy trzeba będzie wykonać jakieś akcje na macierzy).
Clariion (od FLARE29) wspiera także wykorzystanie VLANów i tzw: VLAN Tagging.
Czym są VLANy nie będę tutaj opisywał, gdyż jest to jest dość podstawowe pojęcie z dziedziny sieci komputerowych - w razie potrzeby google bez problemu "pomoże" się dokształcić.
W każdym razie porty ethernetowe Clariiona (bądź te używane do zarządzania, jak właśnie opisywany, a takżę połączenia 1GbE i 10GbE do komunikacji iSCSI) mogą być wykorzystywane w sieci VLANowej. Fizyczne Porty iSCSI mogą także być podzielone na kilka portów wirtualnych, co pozwala na dobrą segregację ruchu do nich przychodzącego. Port zarządzający na SP nie może być w ten sposób podzielony, zresztą i tak nie było by powodu aby to robić.

Zarządzanie modułami I/O i portami:

Moduły I/O w najnowszych Clariionach noszą nazwe UltraFlex I/O.
Tak jak i wszystkie pozostałe komponenty sprzętowe Clariiona można je obejrzeć w sekcji System-->Hardware, gdzie w lewej części ekranu pokazane jest "drzewko", z pokazanymi zależnościami między poszczególnymi częściami macierzy. Środkowa część ekranu to schematycznie pokazana macierz, razem z zaznaczoną wybraną częścią. Ponieważ opisujemy moduły IO i wchodzące w ich skład porty tak więc na poniższym zrzucie ekranowym mamy zaznaczony właśnie ten komponent:


Aby dostać się do właściwości danego komponentu należy go zaznaczyć po czym wybrać przycisk "Properties".

Właściwości Front-End portu:

W zależności czy wybrany port jest portem FC czy iSCSI inne będą jego właściwości.

Port FC:

Podstawowe dane to WWN portu, Szybkość jego pracy (obecna, wybrana, maksymalna).
Oraz garść informacji o inicjatorach znanych temu portowi (czyli takich które się z nim już komunikowały).

Port iSCSI:


Jeżeli chodzi o informacje i opcje przedstawione na tym okienku, to mamy tutja możliwość definiowania adresu IQN dla portu iSCSI oraz jego aliasu. Możemy także sprawdzić MAC adres oraz ustawioną i obecną prędkość z jaką pracuje port. Opcja MTU(bytes) określa maksymalny rozmiar ramki iSCSI, jaka zostaje wysłana - jeżeli nasza sieć obsługuje tzw: jumbo frames to warto z tego skorzystać i ustawić MTU na większe niż 1500.
Dolna część okienka to wypis wszystkich wirtualnych portów zdefiniowanych dla tego fizycznego portu iSCSI. Clariion od FLARE29 (jak wspomniałem opisując właściwości sieciowe kontrolera) wspiera VLANy i VLAN tagging, można więc jeden port fizyczny zaprezentować jako kilka portów wirtualnych (każy w innym VLANie). Dodawanie i konfigurowanie tych portów odbywa się w okienkach które otwierają się po wciśnięciu przycisków Add i Properties. Nie różnią się one niczym od analogicznego okienka dotyczącego ustwień sieciowych kontrolera - podobnie wybieramy IP,maskę,bramę oraz ustawiamy VLAN ID.

Clariion umożliwia także wyświetlenie wszystkich portów i ich podstawowych konfiguracji poza "drzewkiem" sprzętu. Opcja Manage Data Ports jest dostępna po kliknięciu prawym przyciskiem myszy na daną macierz na liście (w okienku Dashboard-u) i wybranie opcji Port Management. Otrzymamy listę wszystkich portów na macierzy, razem z ich opisem, prędkością działania oraz adresami IP lub IQN


To tyle na temat zarządzania kontrolerem i portami.
W kolejnych wpisach zostajemy w temacie zarządzania poszczególnymi urządzaniami/bytami zdefiniowanymi na macierzy lub w jej "otoczeniu". Zaczniemy od tego w jaki sposób macierz widzi i zarządza korzystającymi z niej hostami.

czwartek, 16 sierpnia 2012

Clariion - zarządzanie hardware (dyski)

Po naprawdę długiej przerwie wracam do tematu przygotowania do egzaminu na Clariion specjalistę. Szczerze powiedziawszy mam dość mieszane uczucia co do kontynuowania tego wątku, po pierwsze Clariiony to już zamknięta linia (choć ich następca VNX jest całkiem do nich podobny i podobnie się nim zarządza - przynajmniej jeżeli chodzi o storage blokowy), po drugie ostatnio całkowicie nie mam czasu, żeby porządnie skupić się na przygotowaniach.
Dość narzekania pora wziąć się do nauki, a co dalej będzie z tą serią wpisów to się zobaczy:

Zarządzanie dyskami w Clariionie:

Jednym z najważniejszych elementów w macierzy dyskowej jest oczywiście dysk. W zależności od wielkości danego urządzenia może ich być od kilkunastu do około tysiąca (i więcej).
W Clariionach informacje o tym komponencie można znaleźć w menu Storage-->Disks.  Wybór tej opcji otwiera okno gdzie mamy wylistowane wszystkie dyski jakie znajdują się w danej macierzy:
Dla każdego dysku wyświetlone jest kilka podstawowych informacji:


  • Name (nazwa) ---> dany dysk jest identyfikowany za pomocą trzech liczb oznaczających po kolei: Pętlę (bus) na której znajduje się napęd, Półkę (enclosure) gdzie jest umieszczony i jego pozycję (Disk) na tej półce. 
  • State (stan) ---> obecny  stan dysku
  • Raw Capacity (Pojemność surowa) - ilość przestrzeni dostepna do wystawiania 
  • User Capacity (Pojemność zużyta) - ilość przestrzeni wystawiona do LUNów
  • LUN ID - nr LUNów które mają przestrzeń wystawioną z danego dysku
  • LUN Type - Typ RAIDu w jakim jest dany dysk
  • Hot Spare Replacing - Status dysku Hot Spare
Po wybraniu opcji "Properties" możemy zobaczyć szczegółowe informacje o wybranym napędzie. Dostępne są następujące dane:

Zakładka "General":


Tutaj mamy dużo więcej informacji o wybranym napędzie. Między innymi producenta, model, numer seryjny, wesja firmare itd...

Zakładka Errors:


Ilość błędów na dysku, z podziałem na te przy odczycie/zapisie oraz "miękkie" (soft) i "twarde" (hard).
Soft zwykle znaczy, że nie ma żadnego problemu z samym dyskiem, a jedynie coś się nie udało przy próbie zapisu lub odczytu. Błędy twarde zazwyczaj sygnalizują uszkodzenia samego dysku (np: bad sectory).

Zakładka Statisctics:


Pewne bardzo podstawowe dane wydajnościowe dotyczące pracy dysku. Ilość IOPSów oraz przepustowość, a także utylizacja dysku. Danych raczej mało i dostępny jest tylko "zrzut" stanu obecnego bez możliwości sprawdzenia histroii co raczej ograniczna efektywne wykorzystanie tych informacji.

Zakładka Power Settings:


Na tej zakładce mamy informację, czy dany dysk wspiera zarządzanie oszczędzaniem energii oraz czy jest ono włączone. Zarządzanie polega na zatrzymaniu ruchu obrotowego dysku, kiedy nie jest on używany, dzięki czemu nie zużywa prądu. Minusem jest to, że po odwołaniu się do danych na nim znajdujących najpierw musi wykonać "rozruch" i rozkręcić się do swojej prędkości pracy.

Oszczędzanie energii (Power Saving) dla dysków:
Opcję zarządzania energią dla dysków ustawia się na poziomie RAID grupy. Wszystkie napędy w danej grupie muszą wspierać tą funkcjonalność, aby można ją było uruchomić. Jeżeli jest włączona, mechanizm zatrzyma dyski jeżeli przez czas 30 minut nie będzie do żadnego z nich skierowane żądanie I/O. Po zatrzymaniu dyski potrzebują ok 15sekund na ponowne uruchomienie.
Dodatkowymi warunkami (oprócz pół godzinnej nieaktywności) aby można było uruchomić tryb oszczędzania enterii jest aby, na żadnym LUNie z RAID grupy, nie była uruchomiona replikacja oraz żeby grupa nie zawierała metaLUNów.


Zarządzanie dyskami Hot Spare:
Dyski Hot Spare są to napędy skonfigurowane nie do przechowywania danych ale do zastępowania dysków uszkodzonych. Jeżeli w macierzy jeden z dysków ulegnie uszkodzeniu, to automatycznie na jego miejsce wskakuje rezerwowy "hot spare.
Zgodnie z "dobrymi praktykami" EMC w Clariionach na każde 30 dysków powinien być jeden "hot spare" przy czym rolę tą może pełnić każdy napęd, wyjątkiem są dyski EFD(SSD) które mogą być hot spare tylko dla innego dysku EFD. Pozostałe "dobre praktyki" przy konfigurowaniu dysków HS, to rozmieszczanie ich na tych samych pętlach (Bus) co dyski, które będą one chroniły, a także stworzenie co najmniej jednego HS dla każdego typu (rodzaj, prędkość, pojemność) dysku jaki mamy w macierzy.

Dyski HS w Clariionach są globalne, tzn: nie da się ich przypisać do takiego napędu grupy RAID, LUNa czy pojedynczego dysku która będą chroniły. Każdy HS chroni całą macierz i wszystkie napędy (oczywiście jeżeli jest w stanie - czyli ma odpowiednią wielkość i nie jest dyskiem SSD).

Sytuacje w których dysk HS zastępuje zwykły można podzielić na trzy kategorie:
  • Uszkodzenie dysku
  • Zainicjowanie proaktywnej wymiany automatycznie przez macierz (FLARE)
  • Zainicjowanie proaktywnej wymiany manualnie przez administratora (poprzez GUI lub naviseccli)
Pierwsza sytuacja tłumaczy się sama przez się. W drugiej dysk który zostaje zastąpiony HSem działa sprawnie, jednak na podstawie pewnych przesłanek - przekroczenia pewnych progów alarmowych - macierz uznaje go za napęd zagrożony i przeprowadza proaktywną wymianę. Trzeci wariant to oczywiście decyzja administratora. 
Między uszkodzeniem a proaktywnymi wymianami jest jedna podstawowa różnica. Po awarii dane na dysku są niedostępne, dlatego aby HS mógł go zastąpić musi nastąpić proces odbudowy (rebuild) - zachodzi to automatycznie i wykorzystuje nadmiarowość zapewnianą przez struktury RAID. W przypadku najpopularniejszych RAID5 i 6 odbudowa to rekalkulacja danych wykorzystując kody parzystości. Jest to proces obciążający macierz i dość czasochłonny (szczególnie w przypadku dużych dysków SATA).
Prędkość odbudowy zależy od następujących czynników:
  • Wielkość dysku
  • Rodzaj dysku (SATA,SAS,FC, itd...)
  • Ilości przestrzeni zajętej (przypisanej do LUNów)
  • Priorytetu odbudowy (od ASAP do Low)
  • Obciążenia macierzy (ilości IOPSów)
  • Typu RAID w którym jest uszkodzony dysk
  • Wielkości grupy RAIDowej (dotyczy R5 i R6)
  • Rozłożenia dysków na pętlach FC w macierzy
W odróżnieniu do uszkodzenia, proaktywna wymiana nie wymaga odbudowy, a jedynie przekopiowania zawartości (dysk zastępowany przez "Hot spare" ciągle działa). Generuje to zdecydowanie mniejsze obciążenie macierzy.
Aby zainicjować zastąpienie dysku przez Hot Sprare należy kliknąć w dany dysk na liście i wybrać opcję: "Copy to Hot Spare"


Kolejnymi tematy z cyklu "clariionowych" będą o zarządzaniu pozostałymi komponentami sprzętowymi.

wtorek, 7 lutego 2012

Clariion - Rzut oka na Unisphere + menu do zarządzania macierzą

Trochę czasu upłynęło od ostatniego wpisu związanego z Clariionami i przygotowaniami do egzaminu. Niestety nadmiar zajęć bardziej priorytetowych spowodował, że nieco "odpuściłem" pisanie na blogu.

Ten wpis skupi się na Unisphere i pokaże pewne podstawowe informacje jaki można sprawdzić za pomocą tego interfejsu. Dość dużo będzie zrzutów ekranu, bo nie ma większego sensu opisywanie słowami tego co ładnie można po prostu pokazać.

Start: Dashboard + okolice

Unisphere pojawił się razem z FLARE30 i zastąpił poprzedni interface nazywany NaviSphere.
Zaraz po zalogowaniu się (poprzez wpisanie adresu IP naszego Clariiona do przeglądarki), widzimy tzw: dashboard czyli stonę startową z najróżniejszymi charakterystykami.

Standardowy dashboard bez modyfikacji wygląda następująco:


Poszczególne panele można zmieniać wykorzystując obecny w okolicach prawego górnego rogu przycisk Customize.
Standardowo dostajemy informację o urządzeniach (Clariionach, Centerach i VNXach) w naszej domenie, alarmach i ostrzeżeniach oraz pewne podstawowe dane dotyczące zarządzania pojemnością - zarówno Clariionów jak i macierzy Celerra.

W górnej części mamy poziome menu z kilkoma głównymi opcjami.

  • Dashboard - wyświetlenie dashboardu
  • System List - Lista naszych urządzeń w domenie
  • Domains - Informacje o domenach
  • Alerts - Czyli log z wszyskimi alarmami
  • Support - Opcje związane z serwisowaniem macierzy
Część z tych pozycji jest rozwijalna i udostępnia kolejne "pod-menu":

W tym wpisie chciałbym skupić się na najbardziej rozbudowanej części tego menu czyli pozycji System List
Po przejściu na zakładkę System Lists otrzymamy wykaz naszych macierzy w domenie:


Na tym zrzucie raczej ubogo, jeden samotny Clariion CX-240 :D
Poprzez "prawo-klik" na danym urządzeniu dostajemy się do menu kontekstowego z wieloma opcjami dotyczącycmi zarządzania konkretnym urządzeniem:


Jak widać cała pula opcji do wyboru. Nie będę się rozwodził na temat każdej z nich (większość będzie bardziej lub mniej opisana w kolejnych wpisach).


Menu dla pojedynczego systemu (macierzy)


Po wybraniu jednego z systemów (macierzy), dostajemy kolejne menu i opcje pozwalające nam monitorować/zarządzać nim:


Menu ma następującą strukturę (zaznaczyłem jedynie "pod-menu" w tych ważniejszych pozycjach):

  • System
    • System Information
    • Hardware
    • Hot Spares
  • Storage
    • Summary
    • Disks
    • Pools/RAID Groups
    • LUNs
    • Storage Groups
    • Folders
  • Hosts
    • Summary
    • Host List
    • Virtualization
  • Replicas
  • Monitoring
    • Reports
    • SP Event Logs
    • Event Notification
    • Analyzer
    • Quality of Service Manager
  • Settings
  • Support

I przechodząc po kolei:

Menu System:

Zakładka System Information wygląda następująco:


Główną część okna zajmują podstawowe informacje o danej macierzy takie jak status, nr seryjny adresy IP kontrolerów itd... Na lewo znajduje się panel sterujący podzielony na kilka sekcji, związanych z poszczególnymi typami zadań.


Kolejną opcją w menu system jest Hardware:


Środkową część okna zajmuje lista komponentów macierzy pod postacią "drzewka"
Po prawej stronie możemy zobaczyć szczegółowe własności wybranego komponentu oraz w niektórych przypadkach jego graficzny obraz z zaznaczonym położeniem.

Zakładka Hot Spares jest "nudna" więc nie będziemy jej tutaj prezentowali. Nazwa dość jednoznacznie tłumaczy jej zawartość.

Menu Storage:


Główna zakładka menu storage zawierająca podsumowanie to Summary:


Menu z opcjami po lewej stronie (identyczne dla wszystkich zakładek z grupy Storage) pozwala nam na przeproawdzenie podstawowych operacji na LUNach i Storage grupach, przy czym za najważniejszą należy oczywiście uznać stworzenie nowego LUNa. Dominującą część okna zajmuje coś w stylu "dashboard"-a z ogólnymi informacjami na temat statusu LUNów oraz pojemności i wykorzystania macierzy.

Pozostałe opcje (poza Summary) w menu Storage pokazują nam po kolei kolejne "struktury" jakie tworzymy na macierzy aby finalnie:
Zakładka Disks pokazuje nam jakie dyski mamy w macierzy - czyli zaczynamy od podstawowy fizycznych "cegiełek" dostarczających przestrzeń.
Same dyski nie umożliwią nam jeszcze wystawiania przestrzeni do serwerów, należy je odpowiednio skonfigurować - utworzyć z nich grupy ( w przypadku wystawiania tradycyjnego) lub pule (w przypadku użycia "thin provisioningu"). Każda grupa/pula dysków ma przypisany do siebie rodzaj protekcji RAID (0/1/5/6 itd...). Informacje na temat obecnych na macierzy grup/pul są dostępne w zakładce Pools/RAID Groups:


Mając stworzone struktury RAID można na nich tworzyć LUNy. Czyli te objekty, które będziemy prezentowali dla hostów.
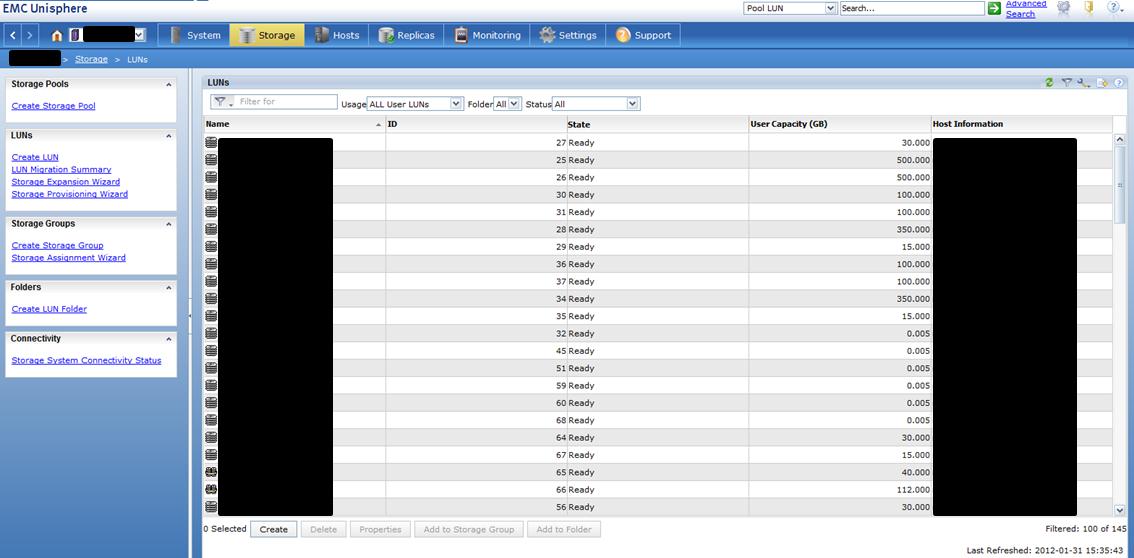
Jak się nietrudno zorientować zakładka na której są informacje o LUNach nazywa się LUNs:


Oprócz obecnych w każdej zakładce menu Storage opcji "zadokowanych" po lewej stronie okna, pozostałą jego część zajmuje lista wszystkich LUNów zdefiniowanych na macierzy razem z pewnymi podstawowymi informacjami o nich (Nazwa, Numer, Status, Pojemność, Do jakiego hosta został wystawiony)

Po stworzeniu LUNów została nam jeszcze tylko jedna rzecz do skonfigurowania na macierzy, tak aby z przestrzeni danego LUNa mógł korzystać host.
Należy wykonać tzw: mapowanie czyli zezwolić macierzy na skomunikowanie się ze sobą wybranego hosta z wybranym LUNem. Wykorzystuje się do tego strukturę nazwaną Storage Group, która składa się z dwóch części. W jednej z nich mamy listę LUNów, a w drugiej listę Hostów. To co robi macierz to pozwala aby wszystkie hosty z grupy, miały dostęp do wszystkich LUNów z tej samej grupy.
Oczywiście przy tworzeniu takich grup mamy do dyspozycji różne warianty i opcje, ale w tym wpisie nie chodzi nam o wyjaśnienie tego procesu ale tylko pokazanie miejsca gdzie w Unisphere są okienka i menu związane z takimi objektami.
Znajduje się to w zakładce Storage Gropus:


W górnej części widzimy listę zdefiniowanych grup a na dole w zakładkach można sprawdzić jakie LUNy i hosty zostały do niej przypisane.

Ostatnia pozycja to Folders , w przeciwieństiwe do pozostałych opcji nie jest to kolejny "krok" przy tworzeniu i wystawianiu zasobów. W tym oknie możemy zobaczyć sobie LUNy podzielone na różne kategorie (foldery) - między innymi: LUNy nie wystawione do hostów, LUNy przypisane do poszczególnych SP, MetaLUNy (czyli kilka LUNów połączonych w jeden). Można także w tym miejscu zdefiniować swoje katalogi i poprzypisywać do nie zasoby.


Menu Hosts:


Tak jak i w pozostałych przypadkach menu host posiada swoją zakładkę Summary:


I tak jak się można domyślić znajduje się na niej kilka okienek z podstawowymi informacjami na temat widzianych przez macierz hostów.

Pozostałe dwie opcje w menu "Hosts" odpowiadają za liste wszystkich serwerów podpiętych do macierzy (Host List) oraz za integrację z VMware (Virtualization).

Dość lakonicznie to opisuję, ale więcej nie trzeba :D


Pozostałe Menu z grupy System List:

Zostały jeszcze 4 nieomówione menu z całej grupy opcji związanych z poszczególnymi macierzami.
Są to mianowicie: Replicas, Monitoring, Settings, Support
Nie będę poświęcał im tyle czasu i uwagi w tym wpisie co pozostałym. Jeżeli chodzi o menu Replicas to oczywiście zawiera ono opcje to tworzenia i konfigurowania najróżniejszych tworów związanych z replikami lokalnymi oraz zdalnymi - same mechanizmy będą opisane w innym miejscu i późniejszym czasie.
Jeżeli chodzi o Monitoring, to każda z jego opcji jest jakby osobnym narzędziem, przy czym niektóre z nich są osobno licencjonowane (np Analyzer czy Quality of Service Manager). One także powinny doczekać się swoich własnych wpisów.
Menu Settings oraz Support są średnio ciekawe i nie ma tam fajerwerków - nazwa mówi wszysko.


Podsumowując:


Wpis dość długi i dodatkowo pełen zrzutów ekranowych.  W zasadzie mam co do niego ambiwalentne uczucia, gdyż to wszysko co jest tutaj opisane poznaje się w ciągu kilkunastu minut "przeklikiwania" się przez macierz. Przygotowanie tego wpisu zajęło mi dużo więcej czasu, szczególnie w zakresie przygotowywania zrzutów i zaciemniania wszelkiego rodzaju numerów seryjnych oraz nazw.
Na pewno pojawi się jeszcze jeden (lub nawet więcej) wpisów związanych z Unisphere, ale będą bardziej treściwe i pokażą jak wykonywać pewne (podstawowe) czynności na macierzy lub gdzie szukać bardziej precyzyjnych ustawień - obiecuję nie będzie już takiej treści ogólnej z zdjęciami dashbordów i listw z menu :D

Choć najprawdopodobniej kolejny post na blogu nie będzie dotyczył Clariionów i przygotowań do nieszczęsnego egzaminu.

sobota, 17 grudnia 2011

Clariion - FAST Cache

Po wpisie dotyczącym autentyfikacji użytkowników i innych spraw średnio przydatnych przy codziennym administrowaniu macierzami, wracamy do zagadnień  "ciekawszych".
Dzisiejszym tematem jest nowa funkcjonalność zaimplementowana we FLARE30 i dostępna w macierzach Clariion CX4 oraz VNX, chodzi mianowicie o FAST Cache. Nazwa może być trochę myląca, ponieważ jest to co innego niż FAST (nazwa na automatyczny tiering w macierzach EMC). Gdyby opisać jednym zdaniem działanie FAST Cache, to jest to wykorzystanie dysków SSD do rozszerzenia pamięci cache.

Podstawy

Funkcjonalność FAST Cache została wprowadzona przez FLARE30 i polega ona na wykorzystaniu dysków SSD, nie jako przestrzeni do wystawiania danych, ale jako rozszerzenie pamięci cache. Można (w zależności od konfiguracji i ilości dysków SSD) "rozbudować" cache macierzy o wielkości od 73GB do 2TB.
Celem takiego ruchu jest oczywiście zapewnienie większej wydajności jaką zapewnia zwiększona "pamięć podręczna". Dyski SSD mają dużo lepsze parametry niż ich "tradycyjni", mechaniczni koledzy i dlatego operacje IO są na nich wykonywane dużo szybciej.
Uruchomienie funkcjonalności FAST Cache może być wykonane podczas działania macierzy i nie wymaga jej wyłączenia, to samo dotyczy zmian (zwiększenia/zmniejszenia/usunięcia) ilości przestrzeni o jaką chcemy "rozbudować" nasz cache.
Do FAST Cache możemy dołączać całe dyski SSD, nie jest możliwe podzielenie dysku na części i wykorzystanie np: kawałka na wystawianie przestrzeni, a reszty dla FAST Cache.
Po uruchomienia FAST Cache wszyskie nowo tworzone LUNy mają domyślnie aktywną opcję korzystania z tej funkcjonalności, jeżeli chcemy uruchomić ją także dla już istniejących zasobów, należy to zrobić ręcznie( włączenie/wyłączenie FAST Cache można robić per LUN lub per storage pula). Zasoby znajdujące się na dyskach SSD mają FAST Cache wyłączony.


Porównanie pamięci cache i FAST cache.

Mimo iż dyski SSD są dużo szybsze niż mechniczne to jednak nie zapewnieją tych samych parametrów i czasów odpowiedzi co "natywny" cache macierzy oparty na kościach DRAM.

W tabelce jest porównanie tych dwóch rodzajów "cache":
Parametr DRAM Fast Cache
Wielkość do 32GB (zależy od modelu macierzy) do 2TB
Czas odpowiedzi nanosekundy do milisekund milisekundy do mikrosekund
Podział Osobne obszary dla odczytu i zapisu Współny obszar używany do "cachowanie" danych na odczyt i zapis
Ziarnistość (min rozmiar danych jakie można zapisać w cache) Rozmiar pojedyńczej strony jest możliwy do zdefiniowania prze użytkownika. Możliwy zakres: od 2Kb do 16Kb Operuje na kawałkach (extends) o wielkości 64Kb
Odporność na awarie Nie jest odporny na utratę zasilania (musi być podtrzymany bateryjnie do czasu zrzutu na dysk). Po uszkodzeniu wymagana interwencja serwisanta. Odporny na zanik zasilania. Uszkodzony dysk SSD w Fast Cache może być zastąpiony hot spare i wymieniony ręcznie.


Działanie FAST Cache:

Czas na opisanie budowy i działania FAST Cache na nieco większym poziomie szczegółowości.
Na FAST Cache składają się dwa komponenty:
  • Policy engine - odpowiada za zarządzanie i odpowiednie kierowanie przepływem żądań IO przez FAST Cache. Ten moduł decyduje który fragmet danych ma być umieszczony w pamięci FAST Cache, dba również o to aby nieużywane fragmenty były z niej usuwane.
  • Memory map - mapa pokazująca jakie dane są w FAST Cache, przechowuje informację o zawartości każdego z 64KB fragmentów na jaki podzielony jest FAST Cache.

Przepływ danych przy włączonym FAST Cache:

Żądania IO przychodzące do macierzy są sprawdzane czy dotyczą zapisu/odczytu z LUNu (lub z puli) która ma włączoną funkcjonalność FAST Cache. Jeżeli tak to sprawdzane jest (w memory map) czy dane te są już w FAST Cache czy nie. Jeżeli ich nie ma, to dalsza "droga" danego IO jest taka sama jak w przypadku nie używania FAST Cache. 

Jeżeli dane są w fast cache to policy engine przekierowuje IO do Fast Cache. Jeżeli IO jest żądaniem odczytu, a dane znajdują się w pamieci DRAM (czyli natywnym cache) to są stamtąd odczytywane, jeżeli ich tam nie ma, do odczyt ma miejsce z dysku SSD,  a dodatkowo dane te są także zapisywane w DRAMie.
Jeżeli od strony hosta przychodzi żądanie zapisu, to jest ono obsługiwane w ten sam sposób, co normalnie (czyli z wyłączonym FAST Cache) - dane trafiają do DRAMu. Różnica polega na tym, że tzw "de-stagingig" czyli zrzucanie danych z pamięci cache na dyski, odbywa się dwuetapowo, najpierw dane są przegrywane z wewnętrznego cache (DRAM) na dyski SSD (Flash Cache), a dopiero potem na dyski mechaniczne. Pozwala to na dużo szybsze czyszczenie pamięci cache na DRAM z tzw "dirty pages", czyli danych które już zostały zaraportowane hostowi jako zapisane, ale ciągle są obecne jedynie w natywnej pamięci cache (DRAM), która nie jest odporna na zanik zasilania.

O tym, które dane są obecne w FLASH Cache, decyduje policy engine. Algorytm który jest wykorzystywany opiera się częstości w jakie hosty wykonują operacje IO na konkretnych blokach danych.
Proces przenoszenia często używanych danych z dysków mechanicznych na SSD nazywany jest Promotion. Przeniesienie danych do których częstość odwołań spadła z FLASH Cacha spowrotem na dyski mechaniczne nazywana jest Write Back.
Co do Write Back to nie mam pełnej jasnosci jak on dokładnie działa: W dokumentacji EMC (h8046-fast-cache-wp) pisze wyraźnie, że dane są kopiowane z SSD na HDD. Nieścisłość według mnie polega na tym, że podczas promocji do FAST Cache dane nie są przenoszone, ale kopiowane, czyli cały czas rezydują w swoim orginalnym miejscu, w cache - czy to zwykłym, czy FAST - znajduje się tylko ich kopia. Operacja odwrotna czyli Write Back nie powinien nic kopiować tylko zaznaczać na memory map, że dany blok nie jest już w tej pamięci obecny.


Jak uruchomić FAST Cache:

Z poziomu Unisphere Fast Cache uaktywnia się po wyborze opcji Storage System Properties na zakładce FAST Cache. Po uruchomieniu funkcjonalność ta jest domyślnie włączona dla wszyskich nowych zasobów.
Przy tworzeniu LUNa można włączyć/wyłączyć używanie przez niego FAST Cache w zakładce Create LUN-->Advanced poprzez zaznaczenie/odznaczenie odpowiedniego pola wyboru.
Dla istniejących LUNów zmiana tego parametru jest możliwa miejscu Properties-->Cache, w przypadku thin pool-i ustawienia FAST Cache są w Properties-->Advance.


Uruchamiać i konfigurować  FAST Cache można również z poziomu CLI:

Uruchamianie FAST Cache:

cache -fast -create -disks -rtype -mode

gdzie:

-disks <-- dyski z których chcemy stworzyć FAST Cache.
-rtype <-- rodzaj protekcji (powinien być RAID1)
-mode <-- tryb ro (read only) lub rw (read write)

Usunięcie FAST Cache:

cache -fast -destroy

wtorek, 15 listopada 2011

Clariion - Unisphere Security Features

Tytuł po angielsku (brakło weny do stworzenia jakiegoś w miarę dobrego tłumaczenia) ale sama treść już w języku ojczystym ;)
Tym razem będzie o czymś na co w praktyce (przynajmniej mojej osobistej) raczej nie zwracałem uwagi. Temat przewodni to bezpieczeństwo a konkretnie sposoby na jakie Clariion (a w zasadzie Unisphere) pilnuje, aby dostępu do niego miały tylko uprawnione osoby i tylko w tym zakresie jaki został im udostępniony.
Ponieważ operacje zakładania i dawania dostępu nowym użytkownikom do macierzy to nie jest coś, co się przeprowadza regularnie i często, tak więc zwykle nie pamięta się wszyskich możliwości i niuansów jakie są z tym związane.
Podejrzewam jednak, że udane podejście do egzaminu na Clariion Specialist wymaga odświeżenia i uporządkowania sobie wiedzy w tym zakresie.

Do rzeczy.

Macierzą można zarządzać przez dwa główne interfejsy. Unisphere - czyli GUI dostępne poprzez przeglądarkę sieciową lub za pomocą linii komend.

Unisphere:

Aby dostać się do Unisphere należy w przeglądarce wpisać adres http://<clariion_ip> - powoduje to uruchomienie apletu Javy. Aplet ten zestawia bezpieczne, szyfrowane połączenie ( SSL/TLS na porcie 443) z storage management serwerem na macierzy. Dzięki temu, mimo iż nie jest bezpośrednio używany https, połączenie jest zabezpieczone.
Szyfrowana jest także cała komunikacja pomiędzy storage management serwerami na różnych macierzach.

Podczas logowania się do macierzy za pomocą Unisphere użytkownik autentyfikuje się podając login, hasło oraz tzw zakres (scope)

SecureCLI:

Podczas używania linii poleceń komunikacja z macierzą jest zabezpieczona w ten sam sposób, co przy łączeniu poprzez Unisphere (szyfrowanie połączenia).
Jeżeli chodzi o autoryzację, to administrator przy wpisywaniu komend, każdorazowo powinien podać login,hasło oraz zakres. Ponieważ takie rozwiązanie nie jest zbyt wygodne mamy możliwość stworzenia tzw "Security File". "Security File" jest przypisany do danego użytkownika na systemie operacyjnym, z którego wydaje się polecenia do clariiona i zawiera w sobie zaszyfrowany login,hasło i scope. Dzięki temu dany użytkownik nie musi ich podawać razem z każdą wysłaną komendą.
Komenda tworząca "Security File" to addusersecurity i ma następującą składnię:
naviseccli -addusersecurity -user <username> -password <pw> -scope<0|1|2>


Sam "Security file" to tak naprawdę dwa pliki które umiejscawiają się na home folderze użytkownika:
SecuredCLISecurityFile.xml i SecuredCLIXMLEncrypted.key

Usunięcie "Security Pliku" wykonuje się poleceniem:
naviseccli -removeusersecurity

Zakres (scope):

Każde konto do zarządzania Clariionami ma jeden z trzech zakresów:

  • Local - konto zdefiniowane na jednej macierzy
  • Global - konto umożliwiające administrowanie każdą z macierzy w domenie
  • LDAP - konto zdefiniowane na serwerze LDAP (np: w domenie AD) i umożliwiające zalogowanie się do każdej macierzy używającej LDAPu do autentyfikacji


Autentyfikacja przez serwer LDAP:

Metoda wykorzystania do zarządzania Clariionami konta z domeny jest najbardziej wygodna. Dzięki temu nie musimy wyodrębniać zarządzania użytkownikami macierzą do innego miejsca i możemy utrzymać centralny punkt (domena np: AD) do zarządzania uprawnieniami.
Macierz musi być najpierw odpowiednio skonfigurowana aby móc na niej korzystać z użytkowników domenowych. Z poziomu Unisphere ustawienia dotyczące LDAPa można znaleźć w menu:

All Systems > Domains > Configure LDAP for CLARiiON Systems

W tym miejscu można przede wszystkim dodać(i zmienić) adresy naszych kontrolerów domeny.
Tutaj także ustawia się interwał synchronizacji. Storage server przechowuje (cache-uje) informacje o kontach i ich uprawnieniach pobrane z domeny tak, żeby każde wydane polecenie nie musiało być autentyfikowane z kontrolerem. Standardowo ten cache jest czyszczony co 24h, ale jeżeli chcemy aby czas ten uległ skróceniu i macierz częściej odświeżała/synchronizowała informacje z domeny możemy zmienić.


Role użytkowników:


Ostatni temat jaki zostanie omówiony w tym wpisie, to role czyli rodzaje kont jakie można założyć na macierzy. Różnią się one, oczywiście, rodzajem uprawnień, a przez to działaniami jakie dany użytkownik może wykonywać.
Dostępne są następujące role:

  • Monitor - użytkownik z uprawnieniami read-only
  • Manager - użytkownik mogący zarządzać macierzą ale nie mający uprawnień do tworzenia i zarządzania kontami użytkowników na niej.
  • Administratror - użytkownik posiadający maksymalne uprawnienia zarówno jeżeli chodzi o zarządzanie macierzą (tworzenie, wystawianie LUNów, definiowanie RAID grup itd..) jak i o zarządzanie użytkownikami
  • Security Administrator - użytkownik mogący tworzyć i zarządzać innymi użytkownikami, ale nie mogący konfigurować macierzy.
Od FLARE29 dostępne są także 3 role do działań związanych z replikacją:
  • Local Replication - użytkownik może wykonywać operacje związane z replikacją lokalną SnapView
  • Replication  - użytkownik może wykonać operacje związane z replikcją zdalną - MirrorView, oraz lokalną.
  • Replication/Recovery - rola podobna jak Replication ale dodatkowo użytkownik może wykonywać operacje "odzyskania" np: roll-back z kopii migawkowej.

Co istotne żadna z tych 3 ról "replikacyjnych" nie zezwala na tworzenie nowych bytów związanych z replikacją (jak klony, kopie migawkowe itd...). Możliwe jest jedynie zarządzanie już istniejącymi obiektami.


poniedziałek, 7 listopada 2011

Clariion - software (przegląd)

Dzisiaj na tapetę bierzemy software na jakim działa Clariion.
Całe oprogramowanie związane z tą macierzą można podzielić na dwie kategorie:
  1. Software na macierzy
    • Management Server & User Interface server
    • Unisphere Agent
    • FLARE

  2. Software zainstalowany na serwerze podpiętym do macierzy
    • Unisphere
    • Unisphere agent (opcjonalnie)
    • Navisphere Secure CLI
    • Unisphere Server Utility
    • Unisphere Storage System Initialization Utility
    • Unisphere Service Manager
    • Management Server & User Interface server (opcjonalnie)

Nieco więcej szczegółów opisujących działanie najważniejszych z tych pozycji oraz wzajemne interakcje między nimi:

Unisphere
Jest to interejs, który pozwala nam poprzez przeglądarke i aplet JAVA podłączyć się do macierzy. Unisphere łączy się z Management Serverem zainstalowanym na Service Procesorze macierzy i dostarcza wygodnego interfejsu do zarządzania jej zasobami.
Unisphere pojawił się razem z FLARE30, w poprzednich wersjach firmwaru powłoka i GUI nazywało się NaviSphere.

Unisphere ( a konkretnie jeden z jego ekranów pokazujący stan komponentów hardware) wygląda następująco:

źródło: Screenshot z własnego ekranu ;) Uruchomione EMC VNXe Demo

Co prawda ten zrzut nie jest z Unisphere działającego na Clariionie ale na jego "następcy" VNXie ale wygląd jest identyczny.
W materiałach EMC Unisphere jest zakwalifikowany jako oprogramowanie "host based" (zainstalowany na serwerze podpiętym do macierzy) ale ja jakoś bardziej bym go umiejscawiał w samym SP - jako część FLARE.

FLARE
Flare (Fibre Logic Array Runtime Environment) jest głównym oprogramowaniem działającym na Clariionie i zapewnia macierzy jej podstawową funkcjonalność (tworzenie RAIDów, obsługa cache etc...).  FLARE jest umieszczony w tzw: vaulcie (5 pierwszych dysków na pierwszej półce dyskowej) i podczas ładowania/startu Service Procesorów jest na nie wgrywany. FLARE tak naprawdę jest to Windows XP z "nakładką" przygotowaną przez EMC.

(Storage) Management Server 
Oprogramowanie działające albo na samym SP w Clariionie albo (opcjonalnie) na wydzielonym serwerze Windowsa. Polecenia jakie użytkownik(administrator) wysyła do macierzy poprzez przeglądarkę sieciową(Unisphere) lub z linii poleceń trafiają do Management Servera. Management Server kieruje następnie dane polecenia do odpowiedniego modułu nimi zarządzającego (np: Performance, Security, Raporty itd...). Wszyskie komendy wymagające zmiany na samej macierzy idą do FLARE.
Management server zajmuje się także zarządzanie tzw: domeną.
Domena jest to grupa Clariionów zarządzana z jednego miejsca. Posiadając więcej macierzy tego typu niezbyt wygodne było by zarządzanie każdą z nich poprzez bezpośrednie logowanie - dlatego tworzy się domenę - pojedynczy punkt zarządzania - i możemy administrować nimi logując się tylko do jednej, wybranej macierzy, która staje się wtedy kontrolerem domeny (nie ma to oczywiście nic wspólnego z kontrolerem domeny Acitve Directory znanego z produktów Microsoft-u).
Jeżeli posiadamy naprawdę dużą liczbę Clariionów (kilkaset) i chcemy je umieścić w jednej domenie, można  rozważyć instalację Management Servera na dedykowanym serwerze z Windowsem i w ten sposób odciążymy Service Procesor macierzy od kontrolowania tak dużej domeny. Ma to jednak sens jedynie w naprawdę dużych środowiskach.

NaviSphere Secure CLI
Jest to interfejs tekstowy (Command Line Interface) za pomocą którego można administrować Clariionami. Jest to metoda alternatywna do graficznego interfejsu dostępnego poprzez przeglądarkę sieciową i Unisphere. Wykorzystując tą metodę zarządzania wydajemy polecenia bezpośrednio do macierzy (do Management Servera) - nie ma tutaj użycia domeny i pojedynczego punktu do zarządzania i monitorowania.


piątek, 21 października 2011

Clariion - architektura (Storage Processor)

Kontynujemy opis architektury Clariiona - tym razem skupimy się na głównym jego komponencie czyli storage procesorze:

Storage Processor (SP) to "mózg" kierujący macierzą (duża część Clariionów ma takich "mózgów" dwie sztuki). On obsługuje żądania I/O jakie trafiają i pilnuje bezpieczeństwa danych i zapewnia żeby odpowiednie hosty miały dostęp do odpowiednich LUNów.

Każdy SP posiada jeden lub dwa (w zależonści od modelu) processory Intel Xeon oraz od 3 do 16GB RAMu.

MODEL CX4-120 CX4-240 CX4-480 CX4-960
Procesor 1 dual core
1,2GHz

1 dual core
1,6GHz

1 dual core
2,2GHz

2 dual core
2,33GHz
Ilość RAMu 3GB4GB8GB16GB


Oprócz tego SP zawiera pamięć cache, która jest podzielona na trzy obszary. W pierwszym znajduje się systemu operacyjny/firmware kontrolera. Nazywa się on FLARE  (Fibre Logic Array Runtime Environment) i tajemnicą poliszynela jest, że tak naprawdę to Windows XP z "nakładką" do obsługi macierzy. Obecnie najnowsza wersja flare w macierzach Clariion to FLARE30.
Pozostałe dwa obszary cache to cache zapisów(write) i cache odczytów(read). Wielkość części zajętej przez system jest stała, natomast możemy zmieniać ilość pamięci przydzielonej na read i write.
Ponieważ pamięć cache jest bardzo szybka w porównaniu do dysków mechanicznych (czy nawet SSD) tak więc jej oczywistym zastosowaniem jest przyśpieszenie obsługi i/o jakie trafiają do macierzy.
Pamięć cache odczytu jest zapełniana danymi, co do których kontroler podejrzewa, że będą potrzebne w najbliższej przyszłości, natomiast do pamięci cache zapisu trafiają wszyskie (z kilkoma wyjątkami) dane wysyłane do macierzy. Po zapisaniu danych do cache macierz wysyła do hosta potwierdzenie udanego zapisu (duży uzysk na czasie niż gdyby host miał czekać aż dane zostaną zapisane na dyskach) a następnie w "czasie wolnym" przerzuca dane z cache na dyski. Więcej o działaniu pamięci cache będzie w jednym z następnych wpisów.

Oprócz CPU,RAMu i pamięci cache , SP zawiera także karty I/O służące do podłaczania do kontrolera serwerów i napędów. Karty mogą być trojakiego typu: FC (z portami o prędkościach do 8Gb/s) lub iSCSI (porty 10Gb/s). Razem z najnowszym release-m firmwaru (FLARE 30,5) Clariion zaczął wspierać także FCOE (Fibre Channel over Ethernet) i jest możliwość dołączenia do niego kart obsługujących ten protokół.


wtorek, 11 października 2011

Clariion - wprowadzenie oraz architektura

Clariion jest to nazwa rodziny (linii) macierzy SANowych pozycjonowanych przez EMC jako "mid-range".
Jest (a w zasadzie był) to jeden z najdłużej rozwijanych produktów, jego początki sięgają wczesnych lat 90 a zaprojektowany i  produkowany był przez firmę Data General (przejętą w 1999r przez EMC).
Linia Clariionów została zamknięta w tym roku i zastąpiona modelem VNX, który łączy w sobie funkcjonalność macierzy SAN i macierzy NAS (tzw: "unifed storage").

Ostatnia generacja macierzy Clariion obejmuje sobą następujące modele: AX, CX4-120 , CX4-240 , CX4-480, CX4-960

Porównanie modeli:

MODEL AXCX4-120 CX4-240 CX4-480 CX4-960
Maksymalna pojemność 120 TB 235 TB 459 TB 939 TB 1899 TB
Maksymalna liczba podłączonych
systemów (hostów)
64128256256512
Maksymalna liczba LUNów
do stworzenia
5121024204840968192
Maksymalna liczba portów
Front End (podłączenie z hostami)
4 FC
lub 4 IP
4 FC i
4 iSCSI
4 FC i
4 iSCSI
8 FC i
4 iSCSI
8 FC i
4 iSCSI
Cache 2 GB6 GB8 GB16 GB32 GB
Max liczba dysków 60120240480960
Wspierane typy dysków SATAII i
SAS
FC, SATA II,
EFD (SSD)
FC, SATA II,
EFD (SSD)
FC, SATA II,
EFD (SSD)
FC, SATA II,
EFD (SSD)


Architektura CLARiiONa:

Ponieważ nie znalazłem żadnego schematu architektury Clariiona, który mógłbym spokojnie tutaj przedstawić, nie naruszając praw autorskich, postanowiłem stworzyć takowy samodzielnie.
Biorąc pod uwagę mój całkowity brak zdolności i wyczucia plastycznego, z góry przepraszam za pewną "toporność" poniższej grafiki ;)

I kilka zdań komentarza:

Clariion jest macierzą z redundantną jednostka centralną (kontrolerem) zwanym w przypadku tej linii: Storage Processor-em (SP). Redundancja jest tutaj użyta nieco na wyrost, gdyż pojedynczy storage procesor moze nie dostarczyć wymaganej wydajności, do obsłużenia intensywnie używanej maciezy. Można powiedzieć, że przy obciążeniu SP do 50% zapewnione jest nadmiarowość tego komponentu, jeżeli jednak macierz pracuje, a każdy z jej SP jest obciążony mocniej niż na 50%, to awaria jednej z tych jednostek może spowodować zatrzymanie całej macierzy.

SP komunikują się między sobą za pomocą magistrali zwanej CMI (Clariion Messaging Interface), magistrala ta jest używana między innymi do przesyłania informacji o zawartości i zmianach w cache, tak żeby obydwa SP zawsze miały dokładnie ten sam jego obraz (mirrored cache) - jest to oczywiście związane z poprawą bezpieczeństwa i redukcją ryzyka utraty danych w przypadku uszkodzenia jedego z kontrolerów.

Back End, czyli połączenie pomiędzy SP (cache) a fizycznymi dyskami, to 4 tzw "pętle" FC (mogą mieć 2 lub 4 GB/s przepustowości). Na pętlach podłącza się półki dyskowe (na powyższym schemacie na każdej pętli podpięta jest jedna półka, w rzeczywistości może ich być kilka), dokonuje się tego za pomocą układu zwanego Link Control Card (LCC). LCC kontroluje stan komponentów w obrębie podłączonej do niej półki.

Na jednej półce dyskowej w Clariionie znajduje się do 15 dysków 3,5cala (istnieją także półki dyskowe "wysokiej gęstości" ale nie będę tu o nich pisał).

Dodatkowe komponenty wchodzące w skład macierzy to oczywiście zasilacze (redundantne), dodatkowo podłączone do baterii SPS, pozwalajacych w wypadku utraty zasilania na potrzymanie zawartości pamięci cache, do czasu jej "zrzucenia" na dyski fizyczne oraz kontrolowane wyłączenie macierzy. Clariion ma także cały zestaw wiatraków używanych (a jakże) do zapewnienia właściwego chłodzenia.


W kolejnym wpisie kontynujemy zagadnienia związane z budową Clariiona.
Trochę bliżej sprawdzimy między innymi działanie i budowę pamięci cache oraz modułów I/O

poniedziałek, 26 września 2011

Get proven 2 - Specialist!

 Ponad rok temu (dokładnie 11 lipca) pojawił się na tym blogu wpis o nazwie Get Proven!, w którym opisałem z grubsza ścieżki certyfikacyjne dla produktów i technologii firmy EMC. Na samym opisie się nie skończyło i kilka następnych miesięcy przygotowywałem się (między innymi przez pisanie i omawianie materiału na tym blogu) do podstawowego egzaminu EMC (E20-001) dającego tytuł Information Storage Assosiate.
Egzamin szczęśliwie udało się zdać i od 1 kwietnia 2011 jestem szczęśliwym posiadaczem certyfikatu i tytułu EMCISA.


Co dalej?
Dalsze plany miałem z grubsza określone - chciałem po przerwie rozpocząć przygotowania do kolejnego egzaminu, już z tych bardziej zaawansowanych (poziom Specialist) a konkretnie do E20-522 CLARiiON Solutions Specialist Exam. Niestety w między czasie EMC zrobiło niespodziankę i zakończyło swoją linię macierzy klasy mid-range Clariion i zastępując ją macierzami typu "unified storage" (czyli SAN+NAS) nazwanych VNX. Miałem pewne dylematy związane z inwestowaniem swojego czasu i wysiłku w naukę o technologii, która jest już zastępowana czymś innym ale ostatecznie postanowiłem jednak podszkolić się i może za jakiś czas podejść do tego E20-522.
Powodów jest kilka: 
Po pierwsze, VNXa to widziałem jedynie na prezentacjach, w artykułach i testach publikowanych w  Internecie oraz miałem okazję pobawić się jego symulatorem (w najbliższej przyszłości będę mógł także jednego "pokatować" w EMC Labie). Jeżeli natomiast chodzi o Clariiony, to mam na stanie całą ich gromadkę i swego czasu nawet głównie na mnie spoczywały sprawy związane z ich administracją. Czuję się po prostu dużo bardziej kompetentny w ich temacie.
Po drugie, Clariion-y całkiem dobrze się jeszcze trzymają i na 100% przez następne kilka lat będziemy je spotykać.
Po trzecie, VNX to tak naprawdę Clariion + Celerra włożone do jednego pudełka i lekko zmodyfikowane. Wiedzę o Clariionie oraz działaniu jego systemu operacyjnego (FLARE30) można bezpośrednio przełożyć na wiedzę o działaniu VNXa (a przynajmniej jego części odpowiedzialnej za dostęp blokowy do danych). Nauka o tej "wycofanej linii" nie będzie czasem straconym a informacje w ten sposób zdobyte przydadzą się przy zarządzaniu VNXami.


Następne wpisy
Podobnie jak przy nauce do poprzedniego egzaminu (wszystkie wpisy otagowane jako E20-001 i rozpoczynające się od ISM) kolejne partie materiału, jakie będę sobie powtarzał/przyswajał mam zamiar umieszczać w formie notatek na tym blogu. Nie wiem jeszcze z jakich źródeł będę korzystał przy nauce, najprawdopodobniej będzie sporo z White Paper-ów EMC (jest tego masę na PowerLink-u) ale rozpocznę od  materiałów szkoleniowych z kursu EMC "Clariion Host Integration an Management with Snap View, SAN Copy and MirrorView". Nazwa długa ale trening był całkiem przyjemny i wartościowy - szczególnie jeżeli chodzi o kompleksowe przypomnienie sobie podstaw.


Niestety z racji małej ilości czasu, wpisy pewnie nie będą pojawiały się regularnie, ale postaram się żeby co jakiś czas coś nowego "spłodzić"
Trzymać kciuki ;)

piątek, 1 kwietnia 2011

EMC Proven!!!

A pochwalę się.
Wczoraj przystąpiłem do egzaminu E20-001 i udało się zdać.
Wynik: 87% na wymagane 61%


Pierwszy krok zrobiony, teraz muszę się zastanowić co dalej.
W planie było przystąpienie do egzaminu z zakresu zarządzania macierzami Clariion ale ponieważ ta linia została ostatnio zamknięta przez EMC to nie wiem czy ma to większy sens.

Na razie cieszę się z EMCISA


sobota, 13 listopada 2010

ISM - Monitorowanie infrastruktury storage

Monitorowanie urządzeń storage powinno dotyczyć czterech obszarów:

  • Dostępności (Accessibility)
  • Zasobów (Capacity)
  • Wydajności (Performance)
  • Bezpieczeństwa (Security)
Dostępność (Accessibility)

O dostępności komponentu mówimy kiedy pracuje on prawidłowo, bez żadnych zakłóceń i awarii. Monitorowanie dostępności zwykle opiera się na ustawieniu pewnych predefiniowanych alarmów, dotyczących prawidlowego działania. Alarmy te definiuje na samym urządzeniu (SAN device, HBA, port, dysk, macierz, element oprogramowania) i są one przechwytywane wystąpienia. Szybkie wykrywanie i naprawa niedostępnych z powodu awarii komponentów, chroni nas przed uszkodzeniem i utratą ciągłości działania całego systemu.


Zasoby (Capacity)

Capacity odnosi się do ilości zasobów storage jakie są dostępne. Przykładami monitorowania Capacity jest np. sprawdzanie ilości wolnego miejsca na systemie plikow lub zużycie quoty na skrzynce pocztowej. Brak monitorowania Capactiy może doprowadzić do problemów wydajnościowych lub nawet dostępności danej aplikacji (przepełnienie). Zwykle dane uzyskane z monitoringu Capacity analizuje się pod względem trendów i według nich planuje przyszłą strategię zakupową dla obszaru storage.


Wydajność(Performance)

Monitorowanie wydajności jest to sprawdzanie jak efektywnie pracują nasze zasoby i w których miejscach mamy tzw "wąskie gardła". Pomiary wydajności, zwykle, polegają na cyklicznym sprawdzaniu różnych parametrów i porównywaniu ich do predefiniowanych wartości. Przykłady zasobów i parametrów jakie można objąć monitoringiem wydajnści to np: Ilość I/O do dysków , czas odpowiedzi aplikacji , utylizacja sieci itd...


Bezpieczeństwo (Security)

Monitorowanie bezpieczeństwa pozwala na wykrycie i zapobieganie nieautoryzowanych prób dostępu. Pomaga także przy śledzeniu nieplanowancyh/nieautoryzowanych zmian wykonywanych w elementach infrastruktury storage. Monitorowanie bezpieczeństwa zapewnia, że nasze dane pozostają poufne, spójne i dostępne. Może ono odbywać się na poziomie software ( np: śledzenie zmian w konfiguracji storage ) jak i  być monitorowaniem fizycznym ( czytniki kart, kamery w halach z macierzami itd...)


Monitorowanie hostów:

Serwery szczególnie te z aplikacjami typu mission-critical powinny być stale monitorowane.
Poszczególne zakresy monitoringu hostów obejmując:

  • Accessibility ( komponenty hardware: HBA,NIC,dyski wewnętrzne ; status kluczowych procesów i usług)
  • Capacity (utylizacja systemu plików, użycie table spaców i log space w bazach , zużycie quoty )
  • Performance ( Utylizacja CPU i pamięci , czasy odpowiedzi )
  • Security ( Autoryzacje i czasy logowań - szczególnie na konta root/administrator )

Monitorowanie sieci SAN:

Poszczególne zakresy monitoringu dla sieci SAN obejmują przykładowo:
  • Accessibility ( Fizyczne elementy sieci SAN i ich komponenty - zasilacze, wentylatory w switchach itd ; błędy pojawiające się w komunikacji w fabricu i zonie )
  • Capacity ( Utylizacja ISL i portów )
  • Performance ( utylizacja portów , monitorowanie opóźnień w sieci i utraty pakietów )
  • Security ( Zoning i LUN Masking , monitorowanie bezpieczeństwa fizycznego środowiska SAN)

Monitorowanie macierzy dyskowych:
  • Accessibility ( Wszystkie elementy hardware maszyny + jej wewnętrzny system operacyjny)
  • Capacity ( surowa i skonfigurowana przestrzeń , ilość przestrzeni zaalokowanej )
  • Performance ( Utylizacja portów FE i BE , czasy odpowiedzi, zużycie cache )
  • Security ( Bezpieczeństwo fizyczne , monitorowanie logowania na macierze )


Sam temat zawierał jeszcze dość dużo przykładów i różnych scenariuszy ( np: analizę dla uszkodzenia portu, HBA, switcha dla monitoringu accessibility), ale były to materiały bardzo ciężkie do wykorzystania bez kopiowania powiązanych z nimi grafik(schematów).
Ogólnie nie było tam nic odkrywczego, tylko sprawy oczywiste typu: "uszkodzenie ścieżki powoduje, że dane są przesyłane drugą z nich"

Kolejny temat to zarządzanie infastrukturą storage.

poniedziałek, 8 listopada 2010

ISM - Rozwiązania zapewniające bezpieczeństwo dla sieci SAN , NAS i IP-SAN

Zapewnienie bezpieczeństwa w sieci SAN

W tradycyjnych sieciach SAN bezpieczeństwo było zapewniane przez odizolowanie jej od sieci LAN i świata zewnętrznego. Obecnie jednak sieci SAN są coraz bardziej zintegrowane z resztą infrastruktury i nie stanowią już odrębnego środowiska. Aby zmniejszyć negatywny wpływ na bezpieczeństwo, jaki ma taka połączenie tych środowisk, wprowadzono protokół FC-SP (Fibre Channel Security Protocol), implementujący mechanizmy zabezpieczenia na styku sieci IP i LAN.
Inną metodologią zabezpieczani sieci storage (SAN , IP-SAN, NAS) jest tzw "defense-in-depth" - polega to używaniu wielu współpracujących ze sobą warstw bezpieczeństwa. Kompromitacja i spenetrowanie przez intruzów jednej z takich warstw, nie ma wpływu na inne, które dalej chronią zasoby sieci storage.


Podstawowe mechanizmy ochrony sieci SAN:

Sposoby ochrony sieci SAN można podzielić na kilka podkategorii:
  • Array-based Volume Access Control
  • Security on FC Switch Port
  • Switch-wide and Fabric-wide Access Control
  • Logical Partitioning on a Fabric: VSAN


Array-based Volume Access Control:
Są to metody, które chronią przed niepowołanym dostępem do urządzeń storage. Dwa najbardziej popularne rozwiązania tego typu to: LUN Masking i mechanizmy Zoningu
Tworzenie zon w sieci  polega na dzieleniu (logicznym) sieci SAN na mniejsze kawałki. Urządzenia zarówno source( hosty) jaki i target (macierze) widzą i są w stanie wymienić informacje jedynie z urządzeniami w tej samej zonie.
Zoning może występować w dwóch odmianach:
  • Hard/port zoning - zony są zestawiane pomiędzy portami na hostach (lub switchach) a portami na macierzy. 
  • Soft/WWN zoning - zony są zestawiane pomiędzy urządzeniami o określonych adresach WWN. Jest to rozwiązanie nieco mniej bezpieczne niż hard zoning - można wyobrazić sobie, iż intruz udaje WWN jednego z członków zony, aby zostać uprawnionym do nasłuchiwania na ruch w niej. Dla porównania przy zastosowaniu hard zoningu musiałby fizycznie odpiąć hosta z zony i wpiąć się w jego miejsce.
Tak jak zoning pozwala kontrolować dostęp danych hostów do macierzy, tak LUN masking pozwala na kontrolę dostępu do poszczególnych LUNów, wystawianych z macierzy. Robi to filtrując listę LUNów do których danych HBA ma dostęp. Silniejszą wersją LUN Maskingu obecną w macierzach EMC Symmetrix jest S_ID Lockdown

Security on FC Switch Ports:
Jest to grupa zabezpieczeń związanych z ustawieniami portów na switchach. Można wśród nich wyróżnić:
  • Port Binding - ogranicza liczbę urządzeń, które mogą używać danego portu do logowania się do fabrica. Ogranicza to zagrożenie WWPN spoofingiem przy soft zoningu.
  • Port Lockdown, Port Lockout - metody ograniczające sposób w jaki dany port może być wykorzystany. Pożna np: wyłączyć możliwość stworzenia połączenia switch-switch albo podłączenia pętli FCAL.
  • Persistent Port Disable - zapobiega włączeniu portu po reboocie switcha.


Switch-wide and Fabric-wide Access Control:
Ta kategoria opisuje mechanizmy kontroli dostępu do sieci SAN i zawiera w sobie następujące rozwiązania:
  • Access control lists - kontroluje podłączenia do SANów i autoryzuje je na podstawie zdefiniowanych polityk. Reguły opisują które HBA i porty macierzy oraz switche mogą być częścią sieci SAN i odcinają urządzenia nieuprawnione.
  • Fabric binding - chroni przed nieautoryzowanym dołączeniem do fabrica zewnętrznego switcha
  • Role-based access control - określa jaki użytkownik i z jakimi uprawnieniami może logować się do poszczególnych urządzeń w fabricu.


Logical Partitioning on a Fabric: VSAN
Mechanizm VSANów jest odpowiednikiem VLANów w sieci Ethernet - polega on na podzieleniu jednej fizycznej sieci SAN, na niezależne od siebie logiczne części. Ruch danych jest możliwy tylko w obrębie jednego VSANu; każdy port (switch, host, array) może należeć tylko do jednego VSANu.
Takie rozdzielenie urządzeń w sieci SAN pozwala na lepszą kontrolę nad dostępami i przepływem danych.


Zapewnienie  bezpieczeństwa w sieci NAS:

Sieć NAS może być narażona na wiele różnych niebezpieczeństwa takich jak na przykład: wirusy , nieuprawniony dostęp , podsłuchiwanie transmisji itd...
Pierwszym poziomem zabezpieczenia są tzw ACLs ( Access Control Lists) określające jakie uprawnienia mają poszczególni użytkownicy. Dane te są następnie uzupełniane o prawa i atrybuty powiązane z plikami i folderami w sieci. Kolejne poziomy bezpieczeństwa są zapewniane przez dodatkowe mechanizmy autoryzacji (np: Kerberos) i ochrony przed nieuprawnionym dostępem (np: firewalle)

Uprawnienia do plików w Windows:
Windows wspiera dwa rodzaje list ACL : discretionary access control lists (DACL) i system access control lists (SACL)
DACL - jest używany do wyznaczenia kto ma dostęp do plików , SACL określa jakiego rodzaju dostęp ma być audytowany (jeżeli audytowanie jest włączone). Dodatkowo w Windows istnieje pojęcie właściciela objektu - które to nadaje właścicielowi prawa do danego pliku nawet jeżeli listy DACL i SACL takiego dostępu zabraniają. Windows wspiera również dziedziczenie uprawnień, pomiędzy objektami przodkami a potomkami.
Każdy użytkownik i grupa jest identyfikowana po unikalnym numerze SID - przydzielanie i sprawdzanie uprawnień odbywa się bazując na tym atrybucie, nie na nazwie pod jaką dany user występuje w systemie.

Uprawnienia do plików w Unixie:
Podstawowymi prawami do plików w systemach Unix/Linux sa odczyt/zapis/wykonanie (Read/Write/Execute). Dla każdego pliku i folderu te prawa określone są na 3 poziomach: właściciel , właściciel grupowy , inni.

Autentyfikacja i autoryzacja współdzielonych plików:
Urządzenia NASowe używają dwóch standardowych protokołów do współdzielenia plików: NFS i CIFS. Autentyfikacja użytkownika próbującego się dostać do zasobów jest wykonywana przez pewien centralny system jak np Network Information System na systemach Unix czy Active Directory w Windowsach.
Autoryzacja określa czy dany (autentyfikowany) użytkownik ma prawo uzyskać dostęp do danego zasobu. Sposoby opisu dostępu do pliku różnią się w przypadku systemów Unixowych ( dostęp typu: rwxrwxrwx) a systemach Windowsowych (listy ACL). Jeżeli jedno urządzenie powinno wystawiać pliki zarówno dla hostów Windowsowych jak i Unixowych to musi ono obsługiwać mappowanie pomiędzy sposobami określania dostępu do zasobów.

Kerberos:
Kerberos jest to sieciowy protokół do autentyfikacji. Został zaprojektowany aby zapewnić bezpieczną autentyfikację dla aplikacji typu klient/serwer i opiera się na silnych algorytmach kryptograficznych. Jego założeniem jest umożliwić przeprowadzenie autentyfikacji klienta na serwerze poprzez niechronioną sieć.
W zastosowaniach związanych z NASami, Kerberos zwykle wykorzystywany jest przy autentyfikacji użytkowników z Active Directory.
Kerberos działa w architekturze klient-serwer. Klientem może być np: użytkownik lub host który otrzymuje service ticket. Kerberos serwer jest zwany także Key Distribution Center(KDC)

Przykładowy procesy autoryzacji z wykorzystaniem Kerberosa w środowisku skladającym się z 4 jednostek:
  • NAS Device (1)
  • Windows Client (2)
  • KDC (3)
  • Active Directory (4)
Proces autoryzacji:

Krok 1:
Użytkownik loguje się do stacji roboczej będącej częścią domeny, używając swojego ID i hasła. Następnie jego komputer wysyła do Autentication Service (AS) na KDC żadanie przesłania ticketu. KDC weryfikuje ID użytkownika w AD.
          
(2) -------ID Proof-------->(3)

Krok 2:
KDC odpowiada poprzez TGT (Ticket Granting Service). Transmisja składa się z dwóch części, jedna może być odkodowana przez klienta, druga przez KDC.

(2)<----------TGT-----------(3)

Krok 3:
Kiedy klient otrzyma TGT odsyła je do serwera KDC wzbogacone o informację na temat zasobu do którego się chce dostać.

(2)---------TGT+Server name----->(3)

Krok 4:
KDC sprawdza uprawnienia użytkownika do danego zasobu w AD

(3)-------------->(4)


Krok 5:
KDC wysyła service ticket do klienta.

(2) <--------Service Ticekt-------(3)

Krok 6:
Klient wysyła Service Ticket do zasobu z którego chce korzystać ( w naszym przypadku macierz NAS)

(2) ------Service Ticekt-------->(1)

Krok 7:
NAS udostępnia zasoby klientowi


Firewalle warstwy sieci:
NAS wykorzystuje sieć IP do przesyłu swoich danych, dlatego też zagrożenia występujące przy używaniu protokołu IP, odnoszą się także do wymiany danych poprzez macierzy NASową.
Jednym z podstawowych zabezpieczeń jest użycie firewalla i filtrowanie przychodzącego i wychodzącego ruchu bazując na adresie źródłowych, docelowym i numerze portu.
Częstą implementacją firewalli jest wykorzystanie ich do stworzenia tzw. Strefy zdemilitaryzowanej ( Demilitarized zone - DMZ).  W środowisku DMZ serwery które muszą być dostępne z sieci zewnętrznej (Intenet) znajdują się pomiędzy dwoma firewallami, natomiast serwery i macierze, które muszą być maksymalnie chronione znajdują się w sieci wewnętrznej.

Sieć zewnętrzna <---> FIREWALL<--->DMZ<--->FIREWALL<--->SIEĆ WEWNĘTRZNA


Zabezpieczanie sieci IP SAN:

Challenge-Handshake Authentication Protocol (CHAP) - mechanizm autoryzacji używany w sieciach IP , za jego pomocą inicjator i target mogą potwierdzić wzajemnie swoją tożsamość, wymieniając pewne sekretne hasło. Jest ono losową sekwencją od 12 do 128 znakówi  nigdy nie jest przesyłane bezpośrednio poprzez sieć, transmituje się tylko jego skrót (hash) stworzony za pomocą funkcji MD5.
CHAP Authentication występuje w dwóch rodzając: one way authentication i two ways authentication

One-Way CHAP Authentication:
Służy do identyfikowania Initiatora poprzez Target.
Schemat działania:
1. Initiator wysyła logon request do targetu i zestawiane jest połaczenie
2. Target wysyła do inicjatora tzw: CHAP Challange
3. Initiator wykorzystuje CHAP Challange oraz znany sobie i targetowi klucz do stworzenia hasha.
4. Hash jest wysyłany do Targetu
5. Target sprawdza czy otrzymany hash jest tym, który był oczekiwany, jeżeli tak połączenie jest autoryzowane.

Two-Way CHAP Authorization:
W tym rodzaju CHAP-sa, najpierw inicjator autentyfikuje się targetowi (one-way CHAP) a następnie ten proces zostaje odwrócony i target autentyfikuje się inicjatorowi.

Zabezpieczanie sieci IP SAN za pomocą iSNS Discovery Domains
iSNS discovery domains pełni tą samą rolę w sieciach IP SAN co zoning w FC. Dzięki temu mechanizmowi możemy podzielić całą sieć na logiczne fragmenty. Jedynie urządzenia w tej samej discovery domain mogą się ze sobą komunikować.


Wpis dość długi i na dodatek dość długo (w porównaniu do poprzednich) przygotowywany. Po części jest to sprawa dość dużej partii materiału zawartego w tym rozdziale, ale również wynika z pewnych zmian jakie zaszły ostatnio w moim życiu zawodowym. W skrócie mówiąc, ilość wolnego czasu, jaki posiadam, z niewielkiego, zmniejszyła się do ekstremalnie małego, co nie pozostanie bez negatywnego wpływu na częstotliwość aktualizowania tego blogu.
Niestety, takie życie...


czwartek, 21 października 2010

ISM - Storage Security Domains

Środowisko urządzeń storage i dostęp do danych na nich składowanych poprzez sieć, rodzi zagrożenia pod postacią ataków i próby uzyskania nieautoryzowanego wejścia i zmiany danych, lub ich uszkodzenia. Aby dobrze zidentyfikować rodzaje zagrożeń dzielimy całą sieć storage na trzy domeny:
  • Appliaction access - domena zawierająca ten fragment sieci, który jest wykorzystywany do dostępu do danych. 
  • Management access - w tej domenie znajdują się wszystkie ścieżki i urządzenia, które wykorzystuje się przy zarządzaniu i konfigurowaniu storage.
  • BURA - obejmuje wszyskie ścieżki danych i urządzania uczestniczące w procesie backup/recovery.

Application Access Domain:

W skład tej domeny wchodzą te komponenty (aplikacje, hosty, urządzania w sieci SAN itd.) które współuczestniczą w ruchu danych z/do urządzeń storage. Przykładowe zagrożenia związane z domeną Application Access to np: podszywanie się jednego hosta za drugiego, w celu uzyskania dostępu do zasobów storage, podsłuchiwanie transmisji w sieci , przeprowadzanie ataku DoS itd... Metody zapobiegawcze to przede wszystkim autentyfikacja i autoryzacja użytkowników, ważne jest także aby macierz mogła widzieć jedynie te hosty które powinny z jej zasobów korzystać.
Przykłady zabezpieczenia i kontroli dostępu użytkownika do danych (ataki typu: podszywanie się pod użytkownika): Autentyfikacja hasłami , NAS: Access Control Lists
Przykłady zabezpieczenia i kontorli dostępu hostów do danych (ataki typu: podszywanie się pod hosta): Zony w sieci SAN , LUN Maskig, iSCSI autentyfikacja wykorzystująca CHAPa
Przykłady zabezpieczeń i ochrony infrastruktury (ataki DoS, podsłuchiwanie transmisji itd...): używanie bezpiecznych protokołów IPSec i FC-SP ( Fibre Channel Security Protocol)
Przykłady zabezpieczeń danych istniejących na macierzach i taśmach (ataki bezpośrednio skierowane w dane: fizyczna kradzież ): Szyfrowanie danych, bezpieczne usuwanie.


Management Access Domain:

Za pomocą komponentów tej domeny możliwe jest zarządzanie urządzeniami storage (monitoring, wystawianie LUNów , provisioning itd...). W większości przypadków sieć zarządzająca to sieć LAN, a dostęp do samych macierzy odbywa się za pomocą CLI (Command Line Interface) lub przeglądarki sieciowej. Zagrożenia związane z Management Access Domain wiążą się z podsłuchem ruchu pomiędzy macierzami, a konsolami zarządzającymi oraz na próbach nieautoryzowanego łączenia się i zarządzania urządzeniami storage. Przeciwdziałania to wprowadzenie dwustronnej autentyfikacji (macierz identyfikuje się hostowi i host macierzy) , używanie bezpiecznych protokołów komunikacyjnych (np: SSH) przy łączeniu się do macierzy. Wydzielenie sieci LAN zarządzającej, od pozostałej infrastruktury sieciowej ( fizyczne rozdzielenie lub zdefiniowanie VLANu )


BURA Domain

BURA obejmuje sobą wszystkie urządzenia i ścieżki danych, które są wykorzystywane przez środowisko backupowe ( takie jak np: taśmy czy replikację ). Zabezpieczenie domeny BURA bazuje zwykle na specyfice działania aplikacji backupowej, gdyż musi bardzo ściśle z nią współpracować. Przykładami ataków w tej domenie to podszywanie się intruza pod serwer backupowy lub DR site, czy próba przechwycenia transmisji danych dla backupu, poprzez podsłuchiwanie kanału komunikacyjnego. Ochrona polega na wprowadzaniu szyfrowanej transmisji oraz mechanizmach autentyfikacji.


Tyle o domenach. W kolejnym odcinku telenoweli pt ISM , prześledzimy zagadnienia związane z konkretnymi
metodami zabezpieczeń w sieciach storage.

sobota, 16 października 2010

ISM - Budowa podstaw polityki bezpieczeństwa w obszarze storage

Czym jest bezpieczeństwo storage?

Jest to wdrożenie pewnych polityk, zasad i praktyk do technologii związanych ze storage. Główny nacisk jest kładziony na zapewnienie bezpiecznego(kontrolowanego) dostępu do informacji.
Podstawowy szkielet zasad i procedur ( tzw: framework ) bezpieczeństwa storage powinien obejmować następujące pojęcia:
  • Poufność (Confidentiality) - zapewnia, że jedynie upoważnieni użytkownicy mają dostęp do informacji. Każda osoba chcące przeczytać lub zapisać dane musi być zautentyfikowana i jej upoważnienia potwierdzone. Dane powinny być przechowywane i przesyłane wyłączenie w postaci zaszyfrowanej.
  • Integralność (Integrity) - zapewnia, iż dane nie zostaną niezauważalnie i bezprawnie zmodyfikowane. Dopusza zmianę jedynie dla uprawnionych do tego użytkowników.
  • Dostępność (Availability) - zapewnia że dane są dostępne zawsze i z odpowiednio dużą szybkością
  • Monitoring (Accountability) -  zapewnia, że wszystkie działania i operacje na danych będą zapisane i przechowywane w logach, w celach audytowych lub sprawdzenia w przyszłości.

Elementy wchodzące w skład bezpieczeństwa

Jednym z najważniejszych pojęć związanych z bezpieczeństwem (nie tylko storage) jest ryzyko (risk), które można opisać jako pewną miarę zagrożenia. Trzy pojęcia związane z ryzykiem to: Zasób (Asset) , Zagrożenie (Threat) i Wrażliwość (Vulnerability)

Elementy bezpieczeństwa: Zasoby
Najważniejszym zasobem jest informacja.
Inne rodzaje zasobów to hardware, software i infrastruktura sieciowa. Głównym zadaniem bezpieczeństwa jest chronienie zasobów. Planując zabezpieczenia należy pilnować dwóch rzeczy: Po pierwsze dane muszą być w łatwy sposób dostępne dla uprawnionych użytkowników i po drugie bardzo ciężko dostępne dla potencjalnych intruzów. Efektywność kosztową systemu zabezpieczeń także można ocenić za pomocą dwóch wskaźników: koszt implementacji systemu musi być nieduży, w stosunku do wartości danych w nim przechowywanych, a jednocześnie koszt przeprowadzenia ataku i uzyskanie nieuprawnionego dostępu powinien być dużo większy, niż wartość samych danych.

Elementy bezpieczeństwa: Zagrożenia
Zagrożenia są to potencjalne miejsca i sposoby ataku na naszą strukturę IT.
Można je podzielić na dwie grupy:
  • Ataki pasywne
    • Próby uzyskania nieautoryzowanego dostępu
    • Zagrożenia dla tajności informacji
  • Ataki aktywne
    • Modyfikacja danych , Denial of Service (DoS)
    • Zagrożenia dla integralności i dostępności danych

Elementy bezpieczeństwa: Wrażliwość
Należy pamiętać, że słaby punkt (wrażliwość) może wystąpić w każdym miejscu/elemencie naszego środowiska ( sieć, system operacyjny , użytkownicy , dostęp fizyczny itd.) i dodatkowo udany atak w tym miejscu może skompromitować cały system i dać intruzowi dowolny dostęp do danych.
Mówiąc o konkretnej wrażliwości systemu można przypisać jej 3 cechy:

  • Attack surface - jest związany z punktem w systemie, który intruz może wykorzystać do przeprowadzenia ataku. Przykładem może być każdy komponent infrastruktury sieciowej , taki jak np konkretny interfejs, protokół, usługa sieciowa itd...
  • Attack vector - to szereg kroków jakie muszą być wykonane aby atak się udał. 
  • Work factor - to ilość czasu i starań jakie są potrzebne aby przejść przez "attack vector"
Aby likwidować lub ograniczać wpływ wrażliwości należy stosować metody zapobiegawcze. Można je podzielić na dwie kategorie: techniczne i nie-techniczne (procedury bezpieczeństwa, fizyczna ochrona obiektów). Jeżeli chodzi o sposób działania to metody przeciwdziałania używają trzech sposobów:
  • Prewencja - likwidowanie wrażliwości lub zmniejszanie ich wpływu
  • Korekcja - usuwanie skutków ataku
  • Detekcja - wykrywanie ataków i uruchamianie mechanizmów prewencyjnych i korekcyjnych.


Już widzę, że ta sekcją będzie dla mnie najcięższa. Tematyka w miarę odległa od tego czym się zajmuję i dużo nowych pojęć. Na szczęście za niedługo już koniec ;)

Kolejny wpis będzie o: Storage Security Domains.